Как мы построили продакшн-архитектуру, обрабатывающую более 1900 сообщений в секунду и десятки тысяч одновременных подключений с использованием Kafka, Redis Pub/Sub, .NET Channels и SSE.
Mofid Brokerage — крупнейший брокер в Иране.
Я написал эту статью на основе реального опыта нашей команды, столкнувшейся с техническими вызовами и тесно работавшей над поиском правильных решений. Нашей целью было отображение актуальных цен на акции и фонды в приложении Mofid, чтобы обеспечить пользователям удобство и актуальность данных.
Это решение положило начало сложному техническому пути. Мы имели дело с огромным объемом данных, которые должны были доставляться из торгового ядра на экран пользователя с минимально возможной задержкой.
Поначалу было много неизвестных: с чего именно начать? Как выявлять и устранять узкие места? И как спроектировать архитектуру, которая останется стабильной во время пиковых нагрузок на рынке?
На первый взгляд требования казались простыми. Однако на практике мы столкнулись с трудностями, которые могли загнать всю систему в тупик, если бы мы не распознали их вовремя.
- Откуда именно поступают данные?
- С какой частотой они генерируются?
- Какими масштабными они могут стать?
- И что еще важнее, как доставлять такой объем данных миллионам пользователей без ущерба для задержки, стабильности и простоты?
- Какой метод использовать для отправки данных клиентам?
В этой статье я хочу поделиться опытом нашей команды в преодолении этих трудностей, принятыми архитектурными решениями и реализованными для достижения цели подходами.
Источник данных о ценах в реальном времени и первоначальные проблемы
Первым шагом стало глубокое понимание источника данных.
Где генерируются котировки в реальном времени и с какой частотой?
Критические рыночные данные, включая актуальные цены на акции и фонды, формируются центральным ядром Организации по биржевому и ценно-бумажному делу (RLC).
Для максимально быстрого получения этих данных другая специализированная команда внутри Mofid отвечает за чтение этого потока.
Они используют для этого C++, что является разумным выбором благодаря близкому расположению к железу и высокой производительности, минимизирующей задержку при чтении информации.
После первичной обработки команда помещает входящие сообщения в кластер Kafka, используя оптимизированный формат Protobuf для уменьшения размера сообщений и увеличения скорости сериализации.
На этом этапе у нас был очень быстрый конвейер, передающий данные из торгового ядра в Kafka.
Следующий вопрос звучал так:
С каким объемом данных мы на самом деле имели дело?
Скорость генерации сообщений напрямую связана с ежедневным объемом торгов на рынке.
Но для проектирования системы нам требовалась точная оценка как нормальных, так и пиковых условий.
Наш анализ показал, что мы в основном имеем дело с четырьмя основными потоками данных:
- Очередь цен последней сделки: около 1000 сообщений в секунду.
- Очередь цен закрытия: около 500 сообщений в секунду.
- Очередь изменений активов пользователя: около 200 сообщений в секунду.
- Очередь изменений доходности пользователя: около 200 сообщений в секунду.
Быстрый расчет показал, что в нормальных рыночных условиях нам приходилось обрабатывать примерно 1900 сообщений в секунду.
Важным моментом было то, что в дни высокой волатильности рынка этот показатель мог легко увеличиваться в два-три раза на короткие периоды времени.
Наша архитектура должна была быть готова к худшему сценарию.
Стратегия передачи данных во внутренние сервисы
Основной задачей на этом этапе была передача этого огромного объема сообщений из Kafka в слой бэкенд-сервисов с минимально возможной задержкой.
Нам требовался инструмент, который мог бы служить очень быстрым посредником.
У нас было несколько вариантов:
- RabbitMQ Streams
- Kafka
- Redis Pub/Sub
Критерии нашего выбора включали пропускную способность, задержку, масштабируемость, простоту обслуживания и потребление ресурсов.
Я уже работал с RabbitMQ в других проектах и знал, что он обладает хорошей производительностью, но мы хотели провести полное сравнение.
Наш выбор: Redis Pub/Sub
Kafka была отличным выбором для приема и поддержки основного потока данных.
Но для слоя риалтайм-рассылки (fan-out) на наши SSE-сервисы нам требовалась быстрая, простая и эфемерная широковещательная рассылка, а не повторное воспроизведение (replay) и долговечность.
По этой причине на данном этапе архитектуры мы выбрали Redis Pub/Sub в качестве легковесного слоя с низкой задержкой между Kafka и бэкендом.
Нашей целью на этом уровне не было сохранение истории сообщений или их повторное воспроизведение.
Вместо этого задачей была доставка последних изменений цен на бэкенд с минимально возможной задержкой.
Redis Pub/Sub использует семантику at-most-once (не более одного раза), что очень хорошо соответствовало природе наших данных.
Если обновление цены несколько секунд назад будет потеряно, оно заменится следующим обновлением.
Напротив, Kafka, Redis Streams и RabbitMQ Streams больше подходят для сценариев, где требуются повторное воспроизведение, долговечность, смещения консьюмеров (consumer offsets), подтверждения (acknowledgments) или более надежная обработка.
Redis уже присутствовал в нашем технологическом стеке, поэтому его выбор не привел к дополнительной сложности для нашей SRE-команды в плане поддержки еще одной технологии.
Разработка также оказалась очень простой.
Реализация: совместно с SRE-командой мы использовали Redpanda Connect для передачи данных из топиков Kafka в каналы Redis Pub/Sub.
Одним из преимуществ Redpanda Connect для нас было то, что оно позволяло сделать конвейер между Kafka и Redis декларативным и наблюдаемым без написания специализированного промежуточного сервиса.
Для максимизации производительности мы настроили выделенный узел Redis в конфигурации, работающей исключительно в оперативной памяти.
Замечание о надежности:
В этом сценарии при перезапуске Redis данные за несколько мгновений могли быть потеряны, а цены могли перестать обновляться на пару секунд.
Учитывая, что основная база данных обновлялась в фоновом режиме с задержкой примерно в пять минут, такой уровень риска инцидентов был приемлем для отображения цен в реальном времени.
Вот как выглядело использование ресурсов Redis в продакшене:
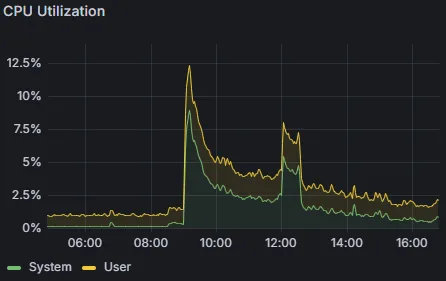
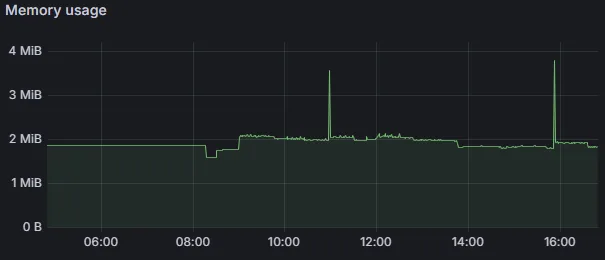
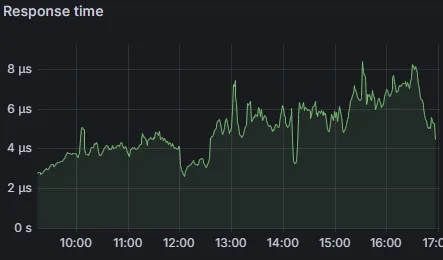
Похоже, для Redis эта нагрузка была сущим пустяком!
Доставка данных клиенту
На этом этапе данные доходили до Redis со скоростью света.
Следующей серьезной задачей стала отправка более чем 1900 сообщений в секунду сотням тысяч подключенных клиентов через браузеры и мобильные устройства.
Мы рассмотрели несколько вариантов организации реального времени для связи с клиентами:
- SignalR
- Socket.IO
- Lightstreamer
- SSE
Нам требовалась технология, которая:
- Обладает высокой масштабируемостью.
- Легко работает в разных браузерах и на различных устройствах.
- Желательно не требует тяжелой клиентской библиотеки.
- Совместима с нашим .NET-стеком.
- Позволяет быстро и просто вести разработку.
Наш выбор: SSE (Server-Sent Events)
Выбирать между этими вариантами было непросто, но у нас были четкие критерии:
Решение должно быть бесплатным, простым в масштабировании и поддержке, не зависеть от санкций, полностью совместимо с нашим .NET-стеком и без труда работать на любых устройствах.
В .NET 10 появились новые классы и возможности, упрощающие работу с SSE, однако это не значит, что SSE нельзя применять в более ранних версиях.
Исходя из наших требований, SSE стали очевидным победителем.
В отличие от WebSockets, предлагающих более сложное двунаправленное соединение, нам требовалось лишь пушить данные от сервера к клиенту.
SSE — это очень простой веб-стандарт, работающий поверх HTTP.
Встроенный в браузер нативный JavaScript-апи EventSource , прекрасная совместимость SSE со стандартной HTTP-инфраструктурой и встроенный в протокол механизм автопереподключения делают свое дело.
Поддержка браузерами также великолепна, и SSE поддерживается уже много лет.
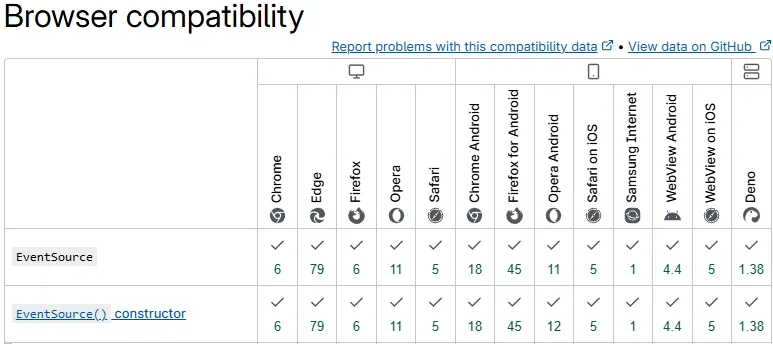
Мы создали пилотный проект (POC) с помощью GitHub Copilot.
Результаты оказались впечатляющими.
Простота реализации и отличная производительность не оставили сомнений в правильности нашего выбора.
Пример бэкенд-кода
[HttpGet]
public async Task GetPrices()
{
    Response.Headers.Append("Content-Type", "text/event-stream");
    Response.Headers.Append("Cache-Control", "no-cache");
    Response.Headers.Append("Connection", "keep-alive");
    Response.Headers.Append("X-Accel-Buffering", "no");

    var id = Guid.NewGuid().ToString("N");
    var cancellationToken = HttpContext.RequestAborted;
    var reader = SubscribersCoordinatorHostedService.Subscribe(id, cancellationToken);

    await foreach (var (eventName, eventData) in reader.ReadAllAsync(cancellationToken).ConfigureAwait(false))
    {
        await Response.WriteAsync($"event: {eventName}\ndata: {eventData}\n\n", cancellationToken).ConfigureAwait(false);
        await Response.Body.FlushAsync(cancellationToken).ConfigureAwait(false);
    }
}
Пример фронтенд-кода
const source = new EventSource("/prices/stream");

source.onmessage = (event) => {
  const price = JSON.parse(event.data);
  render(price);
};

source.onerror = () => {
  console.log("Retrying...");
};
Реализация на стороне клиента: преодоление ограничений
Реализация механизма SSE на клиентской стороне оказалась не менее сложной задачей, чем бэкенд.
Мы сосредоточились на том, чтобы доставлять этот непрерывный поток данных на экран без ухудшения пользовательского опыта.
На клиентской стороне мы столкнулись с шестью основными сложностями и для каждой определили конкретную стратегию.
1. Ограничение браузера на количество одновременных соединений
В случае с HTTP/1.1 действует лимит в шесть одновременно открытых соединений на один домен.
Решение: К счастью, поскольку наша инфраструктура полностью работала на HTTP/2 , это ограничение было эффективно снято благодаря мультиплексированию и поддержке множества параллельных потоков.
В результате мы преодолели это «бутылочное горлышко» без необходимости вносить специальные изменения на клиенте или внедрять SharedWorker .
2. Аутентификация и отправка токенов
Нативный JavaScript-класс EventSource поддерживает только GET и не предоставляет простого способа задать кастомные заголовки, такие как:
Authorization: Bearer
Как же нам было аутентифицировать пользователя?
У нас было три варианта.
Первый вариант: использовать файлы cookie и учетные данные, чтобы браузер отправлял авторизационные cookie вместе с запросом.
Второй вариант: передавать токен в строке запроса (query string) в URL.
С точки зрения безопасности это не рекомендуется, так как токены могут сохраняться в логах сервера или прокси-сервера и утечь.
Третий вариант — наш выбор: использовать пакет eventsource .
Этот пакет предоставляет API, совместимый с EventSource, и при этом дает дополнительный контроль над нижележащим Fetch API.
Это позволило нам кастомизировать запрос, включая добавление заголовков аутентификации, таких как Authorization , сохранив при этом привычную модель программирования EventSource.
Мы хотели снизить сложность реализации и сосредоточиться на бизнес-логике.
Этот пакет помог нам сделать именно это.
3. Шторм обновлений
Учитывая высокую частоту генерации сообщений, если бы мы напрямую обновляли состояние страницы при каждом событии, браузеру пришлось бы выполнять непрерывный и ресурсоемкий рендеринг.
Это увеличило бы количество перерисовок и снизило отзывчивость интерфейса.
Решение: Чтобы обновлять несколько цен на экране одновременно, мы применили стратегию Batch Update.
Мы временно собирали входящие данные внутри ref , а затем с заданными интервалами выплескивали все новые данные в UI разом.
Это сделало интерфейс значительно плавнее и избавило от лагов.
4. Обработка ошибок и переподключение
В реальном мире мобильного интернета и Wi-Fi обрывы соединения неизбежны.
Решение: У SSE уже есть встроенная модель переподключения.
Но для более точного контроля мы решили управлять повторными попытками самостоятельно.
При возникновении ошибки мы закрывали соединение и восстанавливали его после разумной задержки, чтобы избежать лишней нагрузки на сервер.
5. Управление ресурсами при навигации между страницами
Когда пользователи перемещаются по приложению и открывают разные страницы деталей акций или фондов, соединения, открытые для предыдущих страниц, становятся бесполезными.
Поддержание этих соединений активными лишь впустую тратит ресурсы клиента и сервера.
Решение: Очистка (Cleanup).
Когда страница или выбранный фонд меняются и компонент размонтируется, мы немедленно закрываем текущее соединение.
Затем мы открываем новое соединение для данных, необходимых новой странице.
Этот на вид простой шаг оказал огромное влияние на оптимизацию использования памяти браузера и снижение нагрузки на сервер.
6. Начальные значения
SSE-соединение отвечало только за данные в реальном времени.
Чтобы предотвратить рассинхронизацию, клиент сначала запрашивал снимок (snapshot) актуальных цен через обычный API с небольшой задержкой.
Поток (stream) затем применял только последующие изменения.
Тот же процесс получения снимка и ресинхронизации происходил после переподключения, чтобы потеря сообщений Redis Pub/Sub или временная потеря интернета не оставляли на экране устаревшие данные.
Ботлнек бэкенда — обработка на максимальной скорости
Здесь мы столкнулись с одной из самых серьезных технических проблем.
Нам удалось доставить данные в Redis и уже выбрать способ их доставки клиенту.
Но как нам предстояло считывать этот огромный объем данных — примерно 1900 сообщений в секунду из нескольких разных очередей — внутри нашего .NET-сервиса и эффективно распределять их между пользователями?
Мы имели дело с комбинацией публичных данных (таких как котировки акций) и приватных данных (таких как активы конкретного пользователя).
Публичные данные были одинаковы для каждого пользователя.
Например, цена акции.
Приватные данные принадлежали конкретному пользователю.
Например, если пользователь продавал часть своих активов или покупал новые, ему нужно было видеть эти изменения немедленно отраженными в своем портфеле.
Наша архитектура должна была поддерживать оба типа данных.
Она также должна была оставаться достаточно гибкой для добавления новых очередей в будущем.
Проблемы заключались в следующем:
- Высокий объем сообщений в реальном времени.
- Комбинация публичных и специфичных для пользователя приватных данных.
- Высокие требования к параллелизму.
- Масштабируемая архитектура для добавления новых очередей в будущем.
- Большое количество одновременно работающих пользователей, которым требуется рассылка (broadcast).
Для этой критически важной части реализации на .NET мы оценили два основных подхода:
- TPL Dataflow
- Channels
Наш выбор: System.Threading.Channels
Нашими главными критериями были простота реализации, скорость разработки, минимальная задержка, максимальная эффективность и оптимизированное использование оперативной памяти и ЦП.
TPL Dataflow — мощный вариант для более сложных конвейеров, многоэтапных трансформаций, батчинга и моделей, подобных акторам.
Но System.Threading.Channels разработаны специально для высокопроизводительных сценариев producer/consumer с низкими накладными расходами.
Channels в .NET ведут себя как умная, полностью асинхронная FIFO-труба.
По нашему собственному опыту, они показали себя превосходно.
Channels потокобезопасны и отлично оптимизированы для сценариев producer/consumer с низкими накладными расходами.
Бенчмарки Microsoft также показывают, что в подходящих сценариях они могут обеспечить очень высокую пропускную способность при экстремально низких аллокациях.
Это дало нам более чистый и масштабируемый код без необходимости вручную управлять синхронизацией и координацией очередей.
Согласно бенчмарку Microsoft, в тестируемом сценарии Channels значительно превзошли Dataflow как по скорости, так и по использованию памяти.
Мы спроектировали многоуровневую и модульную архитектуру.
Каждый канал Redis обрабатывался HostedService , который отправлял его сообщения во внутренний Channel.
Чтобы очереди не росли бесконечно, мы использовали BoundedChannel емкостью 100k и DropOldest .
Это означает, что максимальная емкость канала составляет 100k.
Мы сделали это по двум причинам.
Во-первых, мы не хотели использовать неограниченную очередь.
Если обработка замедлялась, мы не хотели бесконечно накапливать сообщения.
Во-вторых, наличие предопределенной емкости может улучшить поведение и предсказуемость канала под нагрузкой.
Если после заполнения канала приходят новые сообщения, DropOldest удаляет самое старое сообщение.
Мы также внедрили Coordinator для управления каналами Redis.
Coordinator управляет каналами и создает отдельный канал для каждого пользователя.
Мы не отправляли каждое сообщение абсолютно каждому пользователю вслепую.
Каждое соединение получало только тот поднабор данных, который ему действительно был нужен, основываясь на контексте страницы, активах пользователя или его списке отслеживания (watchlist).
Эта фильтрация держала реальный fan-out под контролем и не позволяла количеству исходящих событий умножаться на общее число рыночных символов.
Архитектура масштабируема и готова к новым очередям.
RLC → C++ Ingestion → Kafka/Protobuf → Redpanda Connect → Redis Pub/Sub → .NET Hosted Services → Coordinator → Per-user/per-subscription channels → SSE → Client batch renderer
Вперед, без страха
Как только мы разработали архитектуру и успешно прошли тяжелые тесты в различных окружениях с помощью команды SRE, настало время для стрессового момента — релиза в продакшн (go live).
Наша стратегия звучала так:
«Релизить без страха» — но с пристегнутым ремнем безопасности.
Мы использовали Unleash в качестве инструмента Feature Toggle.
На первом этапе мы включили фичу только для 30% пользователей.
В то же время мы не сводили глаз с мониторов и дашбордов Grafana.
К счастью, все выглядело отлично.
Мы не заметили никаких проблем или деградации производительности ни на бэкенде, ни в инфраструктуре.
Но во время этого же 30%-го ракаута мы получили важный фидбек от пользователей и нашего продакт-менеджера.
Визуальный эффект при изменении цен на экране был недостаточно привлекательным и не очень хорошо передавал ощущение обновлений в реальном времени.
Именно тогда один из наших фронтенд-разработчиков и я взялись за эту задачу.
Мы решили использовать в качестве ориентира эффект изменения цен из TradingView.
Это хорошо известный и проверенный временем эффект, который обеспечивает отличный пользовательский опыт.
Интересная техническая часть заключалась в том, что мы не хотели писать дополнительный JavaScript для этого визуального эффекта.
Добавление клиентского JavaScript для такого типа обработки могло бы создать дополнительную нагрузку при масштабировании.
Поэтому наша фронтенд-команда воссоздала эффект в стиле TradingView с помощью нескольких простых и чистых CSS-трюков.
Решение оказалось чрезвычайно легковесным, а результат выглядел превосходно.
Внедрив эти визуальные изменения и убедившись в стабильности системы, мы без опасений включили эту функцию для 50% пользователей.
Мы оставались на этом уровне несколько дней, чтобы собрать достаточно данных о поведении системы и пользователей.
Убедившись, что всё работает должным образом, мы приоткрыли заслонку еще немного:
Сначала до 70%, а в конечном итоге — до 100%.
Цифры говорят сами за себя
Проектировать архитектуру на бумаге — это одно.
Увидеть, как она ведет себя под реальной продакшен-нагрузкой — совсем другое.
Одним из наших главных опасений было потребление ресурсов сервера.
Поскольку мы ожидали тысячи одновременных открытых соединений, управление памятью имело критически важное значение.
Чего мы боялись больше всего:
«Что, если очереди переполняются, а мы об этом даже не знаем?»
Итоговый результат удивил даже нас самих.
Благодаря легковесной структуре SSE и эффективному управлению памятью в .NET — в частности, System.Threading.Channels , которая имеет минимальные накладные расходы, — мы смогли справиться с огромным объемом трафика при крайне ограниченных ресурсах.
Мы использовали Prometheus для сбора метрик и Grafana для их визуализации.
Но стандартных метрик оказалось недостаточно.
Мы добавили кастомные метрики в наши Channels, чтобы иметь возможность непрерывно мониторить состояние потока данных:
- Глубина канала (Channel Depth): сколько сообщений ожидает в очереди на обработку? Если это число растет, значит, потребитель (consumer) замедляется.
- Скорость поступления и опустошения (Ingest vs. Drain Rate): скорость поступления данных в Channel по сравнению со скоростью их извлечения.
- Активные SSE-соединения: количество онлайн-пользователей, подключенных к каждому ноду.
Эти дашборды позволили нам выявлять узкие места до того, как пользователи заметили какие-либо замедления.
Результаты мониторинга оказались весьма интересными.
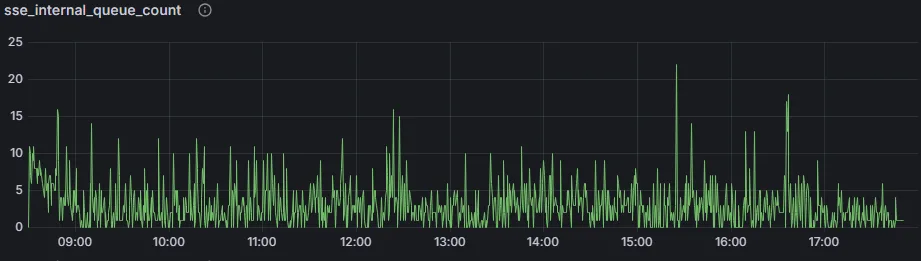
Несмотря на получение примерно 1900 сообщений в секунду, архитектура работала настолько быстро, что на наших графиках внутри Channel в любой момент времени оставалось максимум не более 15 сообщений.
Они опустошались практически мгновенно.
Это означало, что наша внутренняя задержка обработки была фактически близка к нулю.
Это отлично показывает, насколько хорошо Channels проявили себя в работе. ♥️
Бенчмарк и производительность
Возможно, вам интересно, каков же в итоге оказался результат столь пристального внимания к выбору правильных технологий — Redis In-Memory, SSE и Channels.
Результаты в продакшене превзошли наши ожидания.
Архитектура оказалась чрезвычайно легковесной.
Мы смогли справиться с большим объемом трафика при весьма ограниченных ресурсах:
- Архитектура: кластер Kubernetes с 6 активными подами (Pods).
- Использование RAM: каждый под потреблял в среднем всего около 55 МБ оперативки.
- Использование CPU: во время пикового рыночного трафика нагрузка на процессор составляла около 20% на один под.
- Пропускная способность: этот небольшой кластер справился с десятками тысяч одновременных открытых соединений без каких-либо заметных для клиентов задержек.
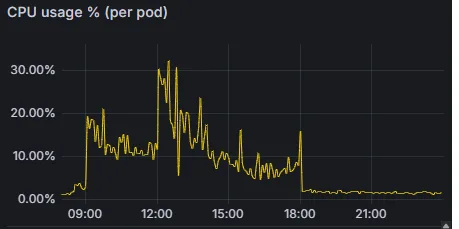
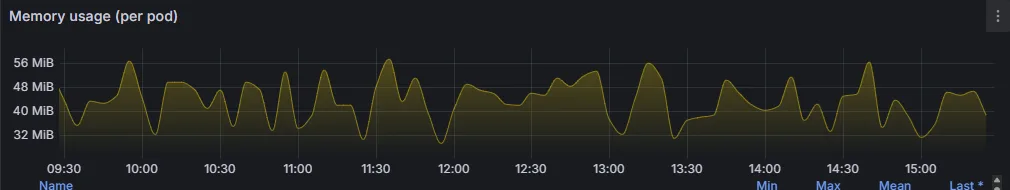
Это означает, что при сравнительно легковесной инфраструктуре мы обслуживаем десятки тысяч пользователей без заметного ухудшения качества или увеличения задержек.
Важные трюки
В процессе реализации мы столкнулись с несколькими серьезными препятствиями.
Уроки, извлеченные из этих проблем, могут оказаться полезными для любой команды, создающей аналогичную систему.
Ловушка прокси
Когда мы только развернули сервис, мы заметили, что некоторые пользователи получают данные с задержками, в то время как другие полностью теряют соединение.
Проблема заключалась не в нашем коде.
Источник крылся в сетевой инфраструктуре и прокси-серверах, таких как Nginx или корпоративные прокси.
SSE использует долгоживущее открытое соединение.
Многие прокси по умолчанию буферизуют ответы перед их отправкой дальше, что может нарушить работу SSE в реальном времени.
Решение: мы установили:
X-Accel-Buffering: no
Мы также убедились, что конфигурация наших прокси позволяет долгоиграющим потокам проходить сквозь них без буферизации.
Проблема утечки памяти
Самый опасный сценарий в этой архитектуре — когда пользователи теряют интернет-соединение или закрывают вкладку браузера, в то время как сервер продолжает запись в их выделенный Channel.
Если такие Channel не очищать, у сервера со временем могут возникнуть серьезные проблемы с памятью.
Решение: Мы очень серьезно отнеслись к механизму RequestAborted в HttpContext .
Как только сервер обнаруживает, что соединение с клиентом было разорвано, мы освобождаем соответствующий Channel и удаляем его из Coordinator.
Масштабируемость
Что произойдет в напряженный торговый день, если наша нагрузка внезапно удвоится?
Действительно ли мы заложили архитектуру под худший сценарий?
Решение: Мы использовали Kubernetes HPA — Horizontal Pod Autoscaler.
Наша система настроена таким образом, что по мере роста числа пользователей и увеличения потребления CPU или RAM Kubernetes автоматически увеличивает количество Pod-ов.
Это помогает гарантировать, что система останется готовой обслуживать пользователей Mofid во время скачков трафика.
Обрывы соединений
Когда клиент отправляет SSE-запрос, могут возникать периоды, когда новые данные отсутствуют.
Например, акция или фонд могут временно прекратить торги, и поэтому по ним не будет новых обновлений цен.
Длинные неактивные соединения также могут закрываться прокси-серверами, балансировщиками нагрузки, шлюзами или другой сетевой инфраструктурой.
Решение: Мы вдохновлялись механизмами heartbeat, используемыми в сетевых протоколах.
Примерно каждые 20 секунд сервер генерирует сообщение HB (heartbeat).
Это помогает нам убедиться, что соединение по-прежнему здорово, а также предотвращает полное простаивание соединения.
Заключение
Этот проект напомнил нам, что в системах реального времени самый сложный инструмент не всегда является лучшим ответом.
Мы оставили Kafka там, где важны отказоустойчивость и возможность повторного воспроизведения.
Мы выбрали Redis Pub/Sub для быстрой и эфемерной рассылки сообщений (fan-out).
В бэкенде мы использовали System.Threading.Channels для построения легковесного пути с низкими накладными расходами для распространения сообщений.
А на клиентской стороне SSE позволил нам передавать цены с низкой задержкой без необходимости использования двунаправленного протокола.
Ключевым моментом было понимание природы данных перед выбором инструментов.
Цена в реальном времени — это заменяемые данные, а не событие, которое никогда нельзя потерять.
Это решение позволило нам осознанно принять ограниченную потерю данных в таких местах, как Redis Pub/Sub и DropOldest , сохранив при этом актуальность, простоту и стабильность системы.
В конце концов, успех этой архитектуры стал результатом не просто выбора правильных технологий.
Он стал результатом правильного сочетания мониторинга, поэтапного развертывания, снимков/ресинхронизации, heartbeat, фича-флагов и тесного сотрудничества между продуктовой, бэкенд-, фронтенд-командами и командой SRE.
Комментарии (0)
Пока нет комментариев — будьте первым.